Kısaca: Load average nedir sorusunun kısa cevabı şudur: Linux sunucuda son 1, 5 ve 15 dakika boyunca işlemci kullanan veya işlemci sırası bekleyen süreçlerle, disk gibi bir giriş/çıkış işlemini bekleyen süreçlerin ortalama sayısıdır. Bu değer işlemci çekirdeği sayısına göre okunur. 4 çekirdekli bir sunucuda 4 civarı bir değer, işlemcilerin sürekli dolu olduğu anlamına gelir. Değer çekirdek sayısını uzun süre aşıyorsa işler sıraya giriyor demektir.
VPS veya sunucu yöneten herkes uptime ya da top komutunun ilk satırında üç sayı görür. Bu yazıda bu üç sayının ne anlattığını, ne zaman endişelenmeniz gerektiğini ve yük yüksek çıktığında nedeni adım adım nasıl bulacağınızı anlatıyoruz.
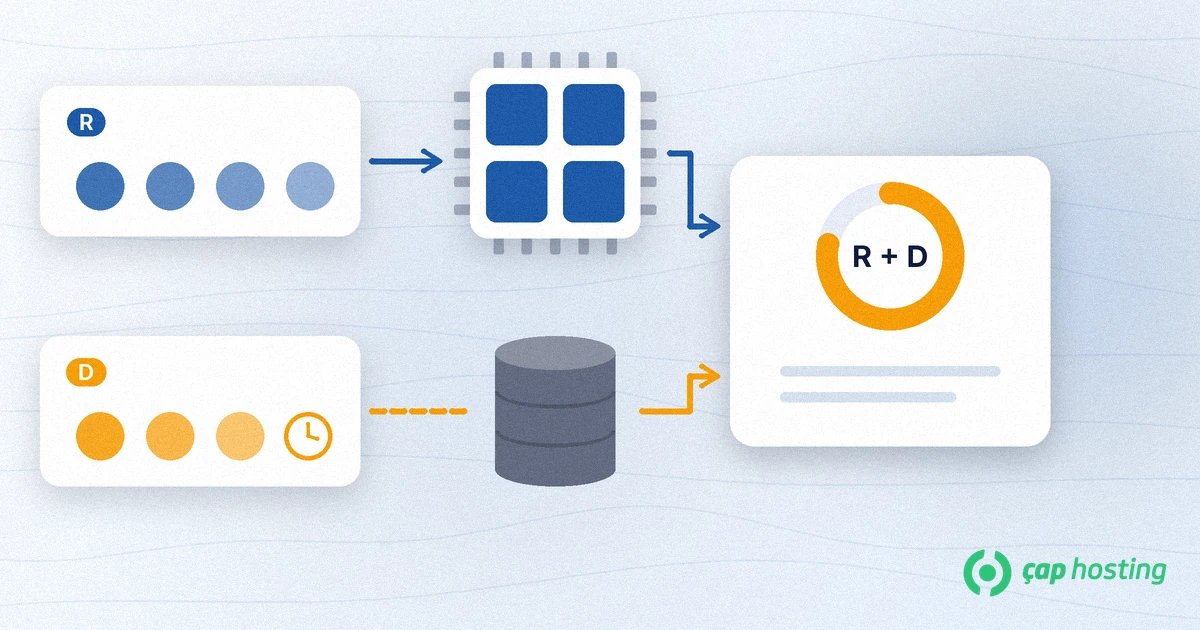
Linux çekirdeğinin /proc/loadavg belgesine göre ilk üç alan, çalışma kuyruğundaki (R durumu) veya disk G/Ç'si bekleyen (D durumu) işlerin 1, 5 ve 15 dakikalık ortalamasıdır. uptime ve top aynı sayıları gösterir. Yani load average yalnızca işlemci yükünü değil, bekleyen işi de ölçer:
Brendan Gregg'in Linux load average incelemesinde anlattığı gibi bu sayılar basit bir ortalama değil, eski değerlerin etkisini giderek azaltan üstel bir ortalamadır. Bu yüzden ani bir yük artışı önce 1 dakikalık değerde görünür, 15 dakikalık değer ise daha yavaş tepki verir.
Örneğin uptime çıktısında load average: 3.90, 2.10, 0.80 görüyorsanız sırasıyla son 1, 5 ve 15 dakikanın ortalamasına bakıyorsunuz. Burada iki şeyi birlikte değerlendirin: değerin büyüklüğü ve yönü.
| Durum | Ne anlama gelir? |
|---|---|
| 1 dk > 5 dk > 15 dk | Yük artıyor. Yakın zamanda bir iş, trafik veya zamanlanmış görev başlamış olabilir. |
| 1 dk < 5 dk < 15 dk | Yük azalıyor. Bir yoğunluk yaşanmış ve geçmekte. |
| Üç değer de benzer | Yük bir süredir aynı seviyede. Çekirdek sayısıyla kıyaslayarak yorumlayın. |
Değerin büyüklüğünü yorumlamak için önce sunucunun kaç işlem birimi kullanabildiğini öğrenin:
nprocuptime belgesi bunu açıkça yazar: load average çekirdek sayısına göre normalleştirilmez. Tek işlemcili bir sistemde 1 değeri işlemcinin sürekli dolu olduğunu, 4 işlemcili bir sistemde ise zamanın yüzde 75'inde boşta kaldığını gösterir. Pratik bir okuma için load average değerini nproc sonucuna bölebilirsiniz. Sonuç 1'in altındaysa genellikle bekleyen iş yoktur, uzun süre 1'in üstündeyse süreçler sıra bekliyordur. Bu her sunucu için geçerli sabit bir eşik değildir; kendi sunucunuzun normal değerlerini zaman içinde izlemek en güvenilir ölçüttür.
Hayır. Linux D durumundaki süreçleri de saydığı için işlemci kullanımı düşükken load average yüksek görünebilir. Bu durumda darboğaz çoğunlukla disktir: yavaş bir depolama birimi, aşırı log yazan bir uygulama, büyük bir yedekleme işi veya bellek yetmediği için swap kullanımı. Gregg'in yazısında belirtildiği gibi bazı kilit beklemeleri de bu sayıma girebilir; bu yüzden tek bir sayıya bakıp karar vermek yerine nedeni ayrıca doğrulamak gerekir.
Tersi de mümkündür: işlemci kullanımı yüzde 100'e yakın görünürken load average çekirdek sayısının altında kalabilir. Bu, işlemcinin dolu çalıştığı ama sırada bekleyen işin az olduğu anlamına gelir ve tek başına bir sorun değildir. Önemli olan, işlerin ne kadar beklediğidir. Kullanıcılar yavaşlık hissetmiyorsa ve değerler normal aralığınızdaysa genellikle müdahale gerekmez.
uptime ile üç değeri, nproc ile çekirdek sayısını kontrol edin.vmstat 1 5 komutunu çalıştırın. vmstat belgesine göre r sütunu çalışmaya hazır süreçleri, b sütunu G/Ç bekleyen süreçleri, wa G/Ç bekleme süresini gösterir. r çekirdek sayısının üstündeyse işlemci, b ve wa yüksekse disk tarafına bakın.st, sanal makineden "çalınan" yani hipervizörün başka işlere verdiği süredir. Bu değer sürekli yüksekse sorun sizin uygulamanızda değil, altyapı tarafında olabilir; sağlayıcınızla paylaşın. Kaynakların nasıl ayrıldığını merak ediyorsanız VDS ve VPS farkı yazımıza göz atabilirsiniz.top içinde CPU'ya göre sıralayarak en çok işlemci kullanan süreci görün. D durumundaki süreçleri listelemek için şu komutu kullanabilirsiniz:ps -eo state,pid,cmd | grep '^D'free -h ile belleği ve swap kullanımını görün. Bellek sürekli doluysa sistem swap'a yazar ve bu da disk beklemesini artırır. Gerekirse swap alanı ekleyebilir, ama kalıcı çözüm için uygulamanın bellek ihtiyacını gözden geçirin.Load average tek başına bir alarm değil, bir göstergedir. Asıl değerli olan, sunucunuzun normal günlerde hangi aralıkta çalıştığını bilmektir. CPU, RAM ve diski birlikte izlemek için sunucu kaynak kullanımı nasıl izlenir rehberimizi kullanabilirsiniz. Ziyaretçileriniz sitenin yavaşladığını söylüyorsa sunucu yükü olası nedenlerden yalnızca biridir; diğer nedenler için web sitesi neden yavaş açılır yazımıza da bakın.
Özetle: üç sayıyı çekirdek sayısıyla kıyaslayın, artış mı azalış mı olduğuna bakın, yüksekse önce işlemci mi disk mi olduğunu ayırın ve ardından süreci bulun. Bu sırayla ilerlediğinizde çoğu yük sorununun nedenini birkaç dakikada görebilirsiniz.
Herkes için geçerli tek bir değer yoktur. Değeri nproc ile bulduğunuz çekirdek sayısıyla kıyaslayın. Değer uzun süre çekirdek sayısının üstündeyse süreçler sıra bekliyordur.
Hayır. CPU yüzdesi işlemcinin ne kadar meşgul olduğunu gösterir. Load average ise çalışan, işlemci bekleyen ve disk bekleyen süreçlerin ortalama sayısıdır. Bu yüzden CPU düşükken load average yüksek olabilir.
Son 1, 5 ve 15 dakikanın ortalaması birlikte yükün yönünü gösterir. 1 dakikalık değer en büyükse yük artıyor, en küçükse azalıyor demektir.
Önce nedeni bulun. Yeniden başlatma yükü geçici olarak düşürebilir ama neden bir uygulama, zamanlanmış görev veya disk darboğazıysa sorun kısa sürede geri gelir.
 Copyright © 2026 Tüm Hakları Saklıdır.
 Türkiye (Türkçe)
 Worldwide (English)